
Huaweiが次世代AI基盤「Ascend 960」を27年1-3月期に投入へ―最大4096基のNPUを光接続
2026年9月19日 16:26

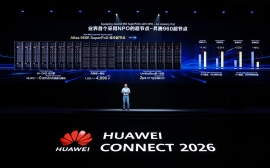
HUAWEI CONNECT 2026でNPO採用の「Atlas 960E SuperPoD」を発表したHuaweiのDavid Wang輪番会長(画像:Huawei)[写真拡大]
Huaweiは2026年9月17日、上海で開幕した「HUAWEI CONNECT 2026」で、次世代AIアクセラレーター「Ascend 960DT」を2027年第1四半期に投入する計画を発表した。2025年に示したAscend 960の投入時期は2027年第4四半期だったため、最大3四半期の前倒しとなる。
同社は併せて、近接実装光学技術「Near-Package Optics(NPO)」を採用した「Atlas 960E SuperPoD」を発表した。最大4096基のNPUを接続し、Huawei公表値でFP8演算性能8エクサフロップス、FP4演算性能16エクサフロップスを実現するという。製品の性能、消費電力、可用性に関する数値は同社による設計値または公称値であり、実運用環境での第三者検証は今後の焦点となる。
■Ascend 960DTを2027年第1四半期に前倒し
Huaweiの輪番会長を務めるDavid Wangは、基調講演「Advancing the Agentic World, Building a Solid Silicon Foundation」で、Ascendシリーズの新たな投入計画を説明した。Ascend 960DTは2027年第1四半期、Ascend 960PRは同年第3四半期に投入する予定である。
Huaweiは2025年9月に公表したロードマップで、Ascend 960を2027年第4四半期に投入するとしていた。今回の計画では960世代が960DTと960PRに分かれ、前者の時期が最大9カ月早まった。一方、公開された公式発表では、両製品の詳細な演算性能やメモリ構成、製造プロセスは明らかにされていない。
同社はAscend 970を2028年、Ascend 980を2029年に投入し、年1世代の更新を続ける方針も示した。演算能力だけでなく、メモリ容量、メモリ帯域、プロセッサー間の接続帯域を世代ごとに拡大する構想である。現段階では将来の製品計画であり、実際の供給時期や性能は量産後に確認する必要がある。
■NPOを採用したAtlas 960E SuperPoD
今回発表されたAtlas 960E SuperPoDは、Huaweiが開発した光インターコネクト「Hi-ONE」と接続基盤「UnifiedBus」を組み合わせる。最大4096基のNPUを一つのシステム内で接続し、大規模AIモデルの学習と推論に必要な演算資源をまとめて利用できるようにする構成だ。
Huaweiによると、Atlas 960E SuperPoDはFP8精度で8エクサフロップス、FP4精度で16エクサフロップスの演算性能を備える。異なる物理サーバーにまたがるメモリを統一的に扱い、NPU間のデータ交換に伴う待ち時間を抑えることを狙う。
Huaweiが2025年に示したAtlas 960 SuperPoDの構想では、最大1万5488基のAscend 960を接続する計画が示されていた。今回発表された4096基構成のAtlas 960Eが従来構想を置き換えるのか、別の製品構成として併存するのかは、公開された発表では明確にされていない。
■光エンジンをチップの近くに配置
NPOは、交換可能な光モジュールを装置前面に置く従来方式と、光学部品をチップパッケージへ統合するCo-Packaged Optics(CPO)の中間に位置する実装方式である。光エンジンを演算チップやスイッチASICの近くに配置し、電気信号が基板上を通る距離を短くする。
高速な電気信号は、伝送距離が長くなるほど損失や波形の劣化が大きくなる。NPOで電気配線を短くすれば、信号補償に必要な回路を減らし、光インターコネクトの消費電力と遅延を抑えやすくなる。光エンジンを交換可能な部品として構成できることも、チップと光学部品を一体化するCPOとの違いである。
Atlas 960Eに使われるHi-ONEは、1基当たり7.2Tbit/sの伝送能力を持つとHuaweiは説明している。同社は、量産NPO製品として初めて光源を内蔵した製品だとしているが、この位置付けはHuaweiの発表に基づく。
■光接続の消費電力を550kW以上削減
Huaweiによると、Atlas 960EではHi-ONEを約5500基使用し、従来構成で必要になる約4万8000個の800G光モジュールを置き換える。これにより、光インターコネクト部分の消費電力をシステム当たり550kW以上削減できるという。
550kWはAtlas 960E全体の消費電力や削減率ではなく、Huaweiが比較対象として設定した光接続構成との差を示す値である。比較条件の詳細や実運用時の消費電力は公表資料だけでは判断できないため、導入後の測定結果が重要になる。
AIシステムでは、接続するアクセラレーターが増えるほど、チップ間通信が性能と電力効率を左右する。Huaweiは個々のチップだけでなく、光接続、メモリ、ストレージ、冷却、ソフトウェアを含むシステム全体を設計することで、利用可能な演算能力を高める戦略を取っている。
■OIFでも12.8Tbit/sのNPO仕様を開発
光通信業界団体のOptical Internetworking Forum(OIF)は、200Gbit/sレーンを用いる12.8Tbit/sおよび6.4Tbit/sのNPOモジュール向け実装仕様を開発している。機械的仕様、電気接続、端子配置、液冷インターフェース、レーザー光源、電源、光コネクターなどを対象とする。
この取り組みは、複数企業の製品を相互接続しやすくするためのImplementation Agreement策定プロジェクトであり、2026年9月時点では開発中である。最終仕様が成立した段階ではなく、HuaweiのHi-ONEとOIF仕様の具体的な適合範囲も公表情報からは確認できない。
NPOの共通仕様が整えば、特定企業の専用構成に限らず、複数の光部品やシステムを組み合わせるための基盤になり得る。Atlas 960Eは、こうした標準化が進む光インターコネクトを大規模AIシステムへ取り入れるHuaweiの具体的な製品提案となる。
■最大100万プロセッサーを接続する構想
Huaweiは、UnifiedBusを中核とする「Peerium Computing Architecture」により、NPUだけでなくCPU、メモリ、ストレージ、ネットワーク機器を共通の接続基盤で連携させる構想を示した。複数のSuperPoDを束ね、最終的には最大100万プロセッサーを一つの論理的な計算環境として扱うことを目指す。
最大100万という数字は、現在稼働している単一システムの実績ではなく、Huaweiが示した拡張構想である。実現には、通信遅延、障害時の経路切り替え、ソフトウェアによる処理分散、電力供給、冷却などを大規模環境で成立させる必要がある。
HuaweiはAIアクセラレーター単体の性能だけで競うのではなく、多数のNPUを接続してシステム全体の演算能力を高める方針を鮮明にした。今後はAscend 960の量産時期と供給量に加え、Atlas 960Eの実消費電力、稼働率、ソフトウェア互換性、実際のAI処理性能が評価の軸となる。
■輸出規制下では個別の確認が必要
米商務省産業安全保障局(BIS)は2025年5月、中国製の先端コンピューティングICに関するガイダンスを公表した。Ascend 910B、910C、910Dを例示し、これらの使用などが事情によっては米輸出管理規則の一般禁止事項10に抵触し、執行対象となるリスクがあると警告している。
このガイダンスは、Ascend製品について世界中の全ての者による使用や販売を一律に禁止したものではない。規制対象となるかは、製品に米国輸出管理規則の対象となる技術や品目が関係しているか、過去または予定される違反を認識しているかといった条件によって判断される。
Ascend 960シリーズは発表時点で出荷前であり、BISの2025年5月の例示リストには掲載されていない。将来の規制適用を断定することはできないため、調達や利用を検討する企業は、製品の供給地域、取引経路、使用技術、契約時点の規則を個別に確認する必要がある。
元記事: Huawei Pulls Ascend 960 Three Quarters Early, Initiates Global AI Interconnect Standard
※この記事はTech Timesから提供を受けた記事を日本向けに翻訳・編集したものです。

スポンサードリンク

