
英アームの次世代サーバー設計基盤「Neoverse CSS N4」、AIインフラ向けにI/Oと電力効率を強化
2026年9月9日 16:29

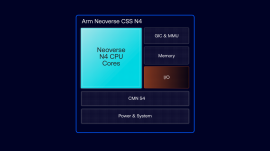
(Arm.com)[写真拡大]
ソフトバンクグループ(SBG)傘下の英半導体設計アーム(Arm)は、クラウド、ネットワーク、エージェント型AIインフラ向けのコンピュート・サブシステム「Arm Neoverse CSS N4」(開発コード名:Ranger)を発表した。ダイ当たり8~128コアを構成でき、Neoverse CSSとして初めてLPDDR6メモリーとPCIe Gen 7に対応する。
CSS N4は完成品のプロセッサではなく、CPUコア、インターコネクト、メモリーやI/Oに関連するシステムIPなどをArmがあらかじめ統合、検証した設計基盤である。シリコン設計企業は、用途に応じてコア数、キャッシュ容量、メモリー、I/O、アクセラレータ接続、チップレット間インターフェースなどを構成し、独自のプロセッサやDPUを開発できる。
■効率重視のNeoverse Nシリーズを強化
Armのデータセンター向けCPUコアには、応答性やスレッド当たり性能を重視するNeoverse Vシリーズと、高いワット当たり性能とスループット効率を重視するNeoverse Nシリーズがある。CSS N4は後者に属し、クラウドのスケールアウト処理、ネットワークのコントロールプレーン、DPU、エージェントのオーケストレーションなどを主な対象とする。
CSSは、個別のCPUコアIPからシステムを構築する場合に必要となる統合や検証の一部をArm側で済ませておく仕組みである。顧客は独自アクセラレータやI/O構成、メモリー設計、チップレット構成など、製品ごとの差別化につながる部分へ開発資源を振り向けやすくなる。
CSS N4に搭載されるNeoverse N4コアはArmv9.3アーキテクチャに基づき、ネイティブのFP8およびMMLAをサポートする。低精度の数値形式や行列演算に対応することで、CPU上で実行するAI処理や、AIシステムを支える周辺処理の効率向上を狙う。
■ダイ当たり最大128コア、最大3.8GHzに対応
CSS N4は、ダイ当たり8~128個のNeoverse N4コアを構成できる。CPU周波数は最大3.8GHzに対応するが、Armは最大コア数と最大周波数を同時に実現する構成を示していない。実際のコア数、周波数、キャッシュ容量は、顧客が設計するチップの用途や電力、面積などの条件によって変わる。
各コアは64KBのL1命令キャッシュと64KBのL1データキャッシュを備え、L2キャッシュはコア当たり最大2MBとなる。共有L3キャッシュはダイ当たり最大256MBを構成できる。
前世代のCSS N2は、ダイ当たり最大64コア、コア当たり最大1MBのL2キャッシュ、ダイ当たり最大64MBの共有キャッシュを備えていた。CSS N4では最大コア数とコア当たりL2キャッシュが2倍、共有キャッシュの上限が4倍に拡大した。
■LPDDR6、DDR5、MRDIMMをサポート
CSS N4は、LPDDR6、DDR5、MRDIMMに対応する。LPDDR6は、JEDECが2025年7月に公開した低消費電力メモリー規格「JESD209-6」である。
Armによると、CSS N4は8000~1万2000MT/s以上のメモリー速度に対応する。採用するメモリーの種類や実装方法は、必要な容量、帯域幅、電力効率などに応じて顧客が選択する。
LPDDR6への対応は、高いメモリー帯域幅と電力効率の両立が求められるAIインフラ、ネットワーク処理、DPUなどを意識したものだ。DDR5に加えてMRDIMMも選択できるため、完成チップの役割やシステム構成に応じたメモリー設計が可能になる。
■PCIe Gen 7を最大128レーン搭載可能
I/Oでは、PCIe Gen 7を最大128レーンまで構成できる。PCIe Gen 7は1レーン当たり128GT/sの転送レートを持ち、x16構成では双方向合計で最大512GB/sの帯域幅を提供する規格である。
最大128レーンという構成では、レーン数だけを基準にすればx16接続を最大8系統設けられる。ただし、完成チップで採用されるレーン数や接続構成は、顧客の設計とシステム要件によって決まる。
高帯域幅のネットワークやGPU、AIアクセラレータとの接続に利用できるほか、CXL 4.0にも対応する。CPU、メモリー、I/Oダイ、カスタムアクセラレータの接続には、Arm Neoverse CMN S4インターコネクトを使用する。
CMN S4は最大16×16のメッシュ構成に対応し、前世代のCMN S3と比べてメッシュ断面のデータ帯域幅を2倍にしたとArmは説明している。CHI C2Cを使用したコヒーレントなマルチチップレット接続にも対応するため、複数のダイを組み合わせたシステムへ拡張できる。
■CSS N3比でソケット性能を最大2倍
Armは、CSS N4について、前世代のNeoverse CSS N3と比べてソケット当たりの性能を最大2倍、ワット当たり性能を最大1.25倍、メモリー帯域幅を最大1.75倍にできるとしている。
性能比較には、最大コア数の構成を3GHzで動作させ、コア当たり2MBのL2キャッシュを搭載する参照条件が使われている。コア数や製造プロセス、システム構成を含むソケット全体の比較であり、Neoverse N4コア単体の性能が2倍になったことを示す数値ではない。
これらはArmが示した設計上の性能値であり、完成した市販プロセッサを第三者が測定した結果ではない。実際の性能や消費電力は、各社が選択するコア数、周波数、キャッシュ、メモリー、I/O、製造プロセスなどによって変わる。
■エージェント型AIを支えるCPU処理を想定
ArmはCSS N4を、次世代のエージェント型AIデータセンターを支える設計基盤と位置付けている。AIエージェントが複数段階の処理を進めるシステムでは、モデルの推論に加え、タスクの分配、ツールやデータベースの呼び出し、状態管理、データ移動、アクセラレータの制御など、多様な処理が発生する。
こうした処理では、GPUによる行列演算だけでなく、CPUによる汎用処理やシステム全体のオーケストレーションも重要になる。多数のCPUコア、高速なメモリー、広帯域のI/Oを組み合わせられるCSS N4は、この情報処理構造を効率よく支えることを狙ったプラットフォームである。
TrendForceは、AIデータセンターにおけるCPUとGPUの構成比が、従来のおよそ1対4~1対8から、推論やエージェント型AIの普及に伴ってCPUの比重を高める方向へ動いていると分析している。ただし、必要な比率は学習、推論、エージェント処理などの用途や、採用するシステム構成によって異なる。
CSS N4は、単一の用途に限定されたプロセッサではない。高コア密度を生かしたクラウドCPUのほか、ネットワークやセキュリティ処理をホストCPUから分離するDPU、高帯域幅ネットワークのコントロールプレーン、アクセラレータやエージェントを管理する専用シリコンなどへの採用を想定する。
■製品化は採用企業の設計に左右
CSS N4は、Armが直接販売する完成プロセッサではない。このため、CSS N4を利用した製品の仕様や製造プロセス、提供時期は、同プラットフォームを採用するシリコン設計企業の開発計画によって決まる。
顧客は、単一ダイだけでなく、マルチチップレット構成や複数ソケットを使用するシステムも設計できる。最大128コアという数字は1ダイ当たりの構成上限であり、チップレットを組み合わせたプロセッサやシステム全体では、それを超えるコア数を実現できる。
現段階で公表されているのは設計基盤としての仕様とArmによる性能値であり、個別の採用製品については、各社からの正式発表を待つ必要がある。完成品が登場すれば、実際の性能、消費電力、メモリー帯域幅、PCIe Gen 7の実装規模などが評価の焦点となる。
CSS N4は、CPUコアの増加だけでなく、LPDDR6、PCIe Gen 7、CXL 4.0、マルチチップレット接続を組み合わせることで、異なる種類のプロセッサやアクセラレータが協調するAIインフラへの対応を進めた。Armにとっては、電力効率を重視するNeoverse Nシリーズを3nm世代へ拡張し、顧客による専用シリコン開発の選択肢を広げるプラットフォームとなる。
元記事: Arm Neoverse CSS N4 Doubles Core Ceiling, Adds LPDDR6 and PCIe Gen 7 for AI Servers
※この記事はTech Timesから提供を受けた記事を日本向けに翻訳・編集したものです。

スポンサードリンク

