
Alibabaの腹部CT向けAI「RADAR」、146所見を解析 放射線科医との協働で感度10%向上
2026年9月20日 18:21

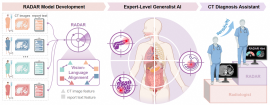
腹部CTを解析する医療画像AI「RADAR」の推論画面。RADARは18の解剖学的構造にわたる146の画像所見を評価する。(画像:Alibaba DAMO Academy)[写真拡大]
Alibabaの研究機関DAMO Academyや浙江大学などの研究チームは、造影腹部CTから18の解剖学的構造にまたがる146の画像所見を解析するAI「RADAR」を開発し、研究成果をScienceに発表した。26人の放射線科医が参加した読影試験では、RADAR単独の性能を上回ったのは上級の放射線科医3人だった。
RADARを放射線科医の診断支援に用いると、疾患検出の感度は10.0%向上し、1症例当たりの読影時間は30.7%短縮した。一方、特異度は98.8%から98.2%へわずかに低下した。現段階では、主に中国の医療機関から集めたデータに基づく研究成果であり、より多様な患者集団や臨床環境での検証が今後の課題となる。
■146の疾患と画像所見を一つのモデルで解析
RADARは「Rapid Abdominal Diagnosis with AI and Radiology」の略称で、造影腹部CTを対象とする汎用的な視覚言語モデルである。肝臓、胆嚢、膵臓、腎臓、消化管、血管など18の解剖学的構造について、疾患や徴候を含む146の画像所見を判別する。
研究チームは、42万4911件のCT検査と、それに対応する放射線診断レポートから学習データセット「RAD-CT」を構築した。各検査を複数のCTボリュームと解剖学的領域に分けることで、約149万8000組のボリューム単位の画像・テキスト対と、1500万組を超える解剖学的領域単位の画像・テキスト対を作成した。
3万9160件の連続症例からなる内部テスト集では、146所見を対象とした平均AUCが0.913、95%信頼区間は0.911~0.915だった。AUCは、所見がある症例とない症例をモデルがどの程度識別できるかを示す指標で、1に近いほど識別性能が高い。
8つの外部医療機関における評価では、AUCは0.874~0.912だった。病理診断で確認された肝臓、膵臓、胃、大腸の4種類のがんに対する評価では、AUCが0.891~0.984となった。別の患者集団を用いた評価では、追加学習なしでAUC 0.883を記録した。
■臓器ごとに画像と診断レポートを対応付け
腹部CTは3次元の画像データであり、病変が画像全体のごく一部にしか現れない場合がある。CT全体と診断レポート全体を一括して対応付けると、どの記述がどの臓器や領域に対応しているのかを学習しにくい。
RADARは、CT画像を解剖学的な単位に分け、それぞれを診断レポート内の対応する記述と結び付ける。例えば、肝臓に関する文章は肝臓の画像特徴と、腎臓に関する文章は腎臓の画像特徴と対応させる。この細粒度の対応付けにより、画像全体に散在する情報から臓器別の診断特徴を学習する。
モデルは、画像を処理する視覚エンコーダー、解剖学的構造をボクセル単位で分割するマスクデコーダー、レポートを処理するテキストエンコーダーで構成される。病名や所見ごとに、その所見が「ある」場合と「ない」場合を表す文章を入力し、画像との類似度が高い方を予測結果として選ぶ。
学習には既存の臨床レポートを使用し、146項目のそれぞれについて新たに手作業で画像へラベルを付ける必要を抑えた。異なる患者間で似た意味を持つ記述を考慮する適応型コントラスト学習も導入し、医師による表現の違いに対応しやすくした。
■26人の放射線科医と比較
読影試験には、中国の14医療機関に所属する放射線科医26人が参加した。参加者は、医療機関の区分と臨床経験に基づき、上級者と若手を含む4グループに分けられた。上級者は臨床経験10年超、若手は10年以下と定義された。
試験では、内部テスト集から選んだ300症例が使用され、61種類の画像所見が含まれていた。参加者は非造影相、動脈相、静脈相を含む多相CTを確認し、所見と結論からなる診断レポートを作成した。
AI支援なしの比較では、放射線科医の特異度は平均98.8%と高かった一方、感度には経験や所属施設による差があった。RADARより良好な成績を示したのは、上級の放射線科医3人だった。この結果は、すべての放射線科医を一律の「診断精度」で順位付けしたものではなく、RADARのROC曲線と各医師の感度・特異度の組み合わせを比較したものである。
1カ月以上の間隔を置いた後、同じ参加者が、症例の順番を入れ替えてRADARの支援を受けながら再度読影した。RADARは予測した陽性所見に加え、判断に関連するとみられる画像領域を示すアテンションマップを提示した。
■AI支援で感度向上、読影時間を短縮
RADARを併用すると、26人全体の疾患検出感度は10.0%向上し、統計的に有意な差が認められた。特異度は98.8%から98.2%へ低下したため、感度の向上と引き換えに偽陽性がやや増えたことになる。
1症例当たりの読影時間は30.7%短縮した。悪性腫瘍の検出感度は7.3%、救急疾患では8.5%、消化管などの中空臓器に関する疾患では9.4%向上した。
最上位区分の医療機関では、RADARの支援を受けた若手放射線科医の感度が、支援なしの上級放射線科医より3.4%高かったが、この差は統計的に有意ではなかった。その他の医療機関では、若手の感度が支援によって10.1%向上し、支援なしの上級者と同程度の水準に達した。
これらの結果は、RADARの役割が放射線科医を単純に置き換えることではなく、見落としの候補を示す第2の読み手として診断を支援することにあると示している。特に、経験による読影性能の差を縮めながら、症例処理にかかる時間を短縮できる可能性がある。
■患者集団と評価方法には課題も
学習データは一つの大規模医療機関から収集され、外部検証も主として中国国内の施設で行われた。研究では別の患者集団による評価も実施されたが、研究チームは、人口統計学的にさらに多様な集団と臨床環境で検証を広げる必要があるとしている。
また、146所見の大規模評価では、すべての症例について病理診断を正解基準にできたわけではない。主な正解ラベルは既存の臨床レポートを基に作成され、一部の重要な疾患について病理診断による追加評価が行われた。
読影試験でも、元の臨床レポートから抽出して人手で確認した所見が正解基準として使われた。300症例を同じ参加者が2回読む設計だったため、研究チームは1カ月以上の間隔と症例順の無作為化によって記憶の影響を抑えたが、実際の診療現場とは条件が異なる。
公開リポジトリには、RADARの学習・推論用コード、事前学習済みチェックポイント、デモ用データ、前処理および評価の手順が用意されている。研究機関が追試や追加検証を進められる環境が整ったことで、異なる患者集団や施設で性能を確かめるための基盤となる。
元記事: Alibaba Radiology AI Outperforms 23 of 26 Radiologists Across 146 Diseases in Science
※この記事はTech Timesから提供を受けた記事を日本向けに翻訳・編集したものです。

スポンサードリンク

