
言葉だけでなく「声のトーン」も理解、KDDIがGemini搭載の接客ロボット
2026年7月31日 12:44

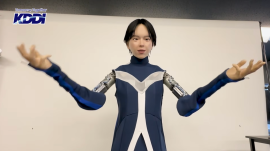
(Kddi.com)[写真拡大]
KDDIとAVITAは、Googleのリアルタイム音声AIモデル「Gemini 3.1 Flash Live Preview」を搭載した接客用ヒューマノイドロボットを披露した。従来の音声認識システムで生じていた応答遅延や感情情報の欠落を抑え、声の高さや話すペースを踏まえた自然な対話を目指す。2026年秋には商業施設での実証実験を予定しているが、実環境で従来の接客ロボットとの違いを示せるかは、今後の検証課題となる。
■従来の接客ロボットが抱えていた課題とPepperの教訓
日本では10年以上にわたり接客用ヒューマノイドロボットが開発されてきたが、その多くはおおむね同じ課題に直面してきた。言葉そのものは聞き取れても、その言葉が「どのように」発せられたかを理解できなかったのだ。顧客の問いかけに苛立ち、ためらい、切迫感が含まれていても、ロボットは言葉だけに反応し、それ以外の重要な情報を捉えられなかった。
7月30日から31日まで東京ビッグサイトで開催されるGoogleの国内向け主要クラウドカンファレンス「Google Cloud Next Tokyo」で、KDDIとAVITAは、この状況が変わったという考えに基づいて設計したヒューマノイドロボットを展示している。KDDIの公式発表によると、南展示棟のKDDIブース(P8)で稼働するロボットは、感情のニュアンスをリアルタイムに保持するために構築されたGoogleのエンドツーエンド音声モデル「Gemini 3.1 Flash Live Preview」を国内で初めて採用したものだという。従来モデルとの違いは段階的な性能向上ではなく、アーキテクチャそのものにある。
2014年に登場し、約2万7,000台が製造された後、2020年に生産が停止されたソフトバンクの「Pepper」は、日本の接客用ヒューマノイドを商業展開した試みとして、最も詳しく記録されている例である。その問題は具体的で、示唆に富んでいた。Pepperは感情を示す手がかりを安定して認識できなかった。発話区間の検出から音声のテキスト化、言語モデルによる処理、音声合成へと進むパイプラインのどこかで、顧客の声の高さや質問する速度、不安による震え、苛立ちを示す平板な調子といった情報が失われていた。最後に残るのは、こうした意味合いを取り除かれた文字起こし結果だった。
2026年3月下旬に提供が開始されたGemini 3.1 Flash Live Previewは、そのようなパイプラインを採用していない。このモデルはネイティブな「音声対音声(audio-to-audio)」方式であり、生の音声を入力としてエンドツーエンドで処理し、話者の声を途中でテキストに変換してから音声に戻すことなく、音声による応答を生成する。Googleの開発者向けドキュメントでは、声の高さや話す速さなどの「音響的なニュアンス」をリアルタイムに認識するために設計されたモデルと説明されている。KDDIの発表によれば、従来のAPIをつないだ方式では応答に「数秒」の遅延が生じていたが、新しいアーキテクチャでは、その遅延が事実上解消されるという。
技術レビューでは、この変化について、音声AIの技術者が「待ち時間の積み重ね(wait-time stack)」と呼ぶ問題を解消するものだと説明されている。これは、文字起こし、推論、音声合成の各工程が前の工程の完了を待つことで、遅延が累積する現象である。ためらいながら話す顧客や、文の途中で言葉を切って話の方向を変える顧客の発話も、不完全なテキスト断片として処理されるのではなく、その発話が持つ音響的な特徴を踏まえて応答できるようになる。
■画面上のアバターから物理的なロボットへの進化
AVITAは、最初から物理的なヒューマノイドを手がけていたわけではない。AVITAの公式サイトによると、同社は大阪大学の知能ロボット研究分野で特任教授を務め、ロボット工学分野で広く知られる石黒浩氏によって2021年6月に設立され、デジタルアバターを中心とする事業から出発した。同社の「AVACOM」プラットフォームは、自動精算機のそばにCGアバターのインターフェースを設置し、在宅で働く身体障害者を含む遠隔地のオペレーターが、アバターを通じてリアルタイムに接客するシステムである。
このシステムは2022年後半からローソンのコンビニエンスストアに導入され、その後さらに深刻化した人員確保の問題への対応に使われてきた。日本経済新聞の調査によると、直近の年度にはコンビニエンスストア運営事業者の62%超が、十分な人数のパート・アルバイト従業員を確保できずにいた。2025年初頭までに、当時約70人だったローソンのアバターオペレーターは、東京、大阪、福岡の28店舗で業務にあたっていた。ローソンは深夜帯のシフトを時差によって補うため、スウェーデン在住の海外リモートワーカーも初めて採用した。同じAVACOMシステムは、三井住友銀行の拠点や、KDDIが全国で展開する「au Style」の店舗にも導入されている。
AVITAが物理的なヒューマノイドへ移行することは、石黒氏が「論理的な拡張」と表現してきたものだ。聞くことと話すことができる画面上の存在から、動き、身ぶりを示し、顧客と物理的な空間を共有できる身体を持つ存在へと発展させるという考えである。2026年3月、KDDIとAVITAは、この取り組みを「Physical AI」に関するパートナーシップとして正式に発表した。発表は「MWC Barcelona」で行われ、会場ではヒューマノイドのコンセプトモデルも展示された。今回のGoogle Cloud Next Tokyoで稼働しているGemini統合版は、そのコンセプトを実用化に向けて発展させたモデルである。
■システムを支える3つの技術レイヤー
今回のシステムでは、3つの技術レイヤーが連携して機能している。
会話処理の中核では、Gemini 3.1 Flash Live Previewが、GoogleのLive APIによる双方向のWebSocketストリーミングを通じて動作する。これは、ロボットが入力音声を処理しながら同時に応答を生成できる全二重通信チャネルである。従来のシステムで必要だった発話の順番を管理するロジックを使わず、会話中の自然な割り込みにも対応する。このモデルは90以上の言語をサポートし、言語を自動検出できる。日本で増加する、訪日客や日本語を母語としない労働者に対応するうえでも重要な機能となる。
ロボットとクラウド側のAI処理との間でデータを運ぶのは、国内第2位の携帯通信事業者であるKDDIが運用する5G通信基盤だ。KDDIが説明する応答性でリアルタイム推論を行うには、信頼性が高く、広帯域かつ低遅延の通信が必要になる。一般的なWi-Fiや4G回線を使えば、モデルのアーキテクチャが解消しようとしている遅延が再び生じることになる。GPUによる計算処理は、2026年1月に開設されたKDDIの大阪堺データセンターで行われている。両社は同じ施設でGeminiをオンプレミス展開することも検討している。実現すれば通信の往復遅延をさらに短縮でき、医療分野など規制を受ける業界で、データを所定の地域や環境内に保持するデータ主権上の要件に対応する道も開ける。
ハードウェアは、石黒氏がプロデューサーを務めた2025年大阪・関西万博の「いのちの未来」パビリオン向けに開発した設計をベースとしている。ヒューマノイドの顔にはシリコン製の皮膚と、圧縮空気で駆動する空気圧アクチュエータが使われている。これにより、電動サーボ機構に見られるぎこちなさや動作音を抑え、静かで柔らかく、自然に見える表情を作り出す。目の周辺に組み込まれたカメラセンサーは周囲の動きや物体を検知し、人が相手を目で追うように、顧客へ自然に視線を向けられるようにする。全体の外観は、初期の写実的なアンドロイドが直面した「不気味の谷」を引き起こさず、人間同士の会話で自然と感じられる範囲に収まることを意図して設計されている。
■日本特有の労働力不足という背景
このシステムを商業展開する理由は、抽象的なものではない。日本の生産年齢人口は1990年代半ばにピークを迎え、その後は毎年減少している。日銀短観の雇用人員判断DIは全産業でマイナス35となり、過去30年間で最も深刻な人手不足を示す水準となっている。帝国データバンクが2026年4月に1万500社以上を対象として実施した調査では、50.6%が正社員不足を報告し、7業種で不足の割合が60%を超えた。リクルートワークス研究所は、2030年に日本の労働供給が約341万人不足すると予測している。
KDDIとAVITAは、人手不足の圧力が特に大きい分野として、小売、医療・福祉、エンターテインメント、文化・芸術施設の4分野を挙げ、ヒューマノイドの活用先として明確に位置づけている。これらは、人の温かみや細やかな気配り、苦痛や切迫感に応じる能力が付加的な機能ではなく、仕事そのものとなるサービス環境である。すべての発話を同じような文字起こし結果として扱うのではなく、声のトーンを聞き取り、それに応じて反応できるロボットは、これらの環境で従来商業規模で展開できたシステムとは異なる種類の道具となる。
2026年秋には商業施設での実証実験が予定されている。その段階では、実際の顧客とのやり取りから収集した映像データや動作データをAIの学習工程にフィードバックし、ヒューマノイドの自律動作の精度向上に役立てる計画だ。将来の導入候補には、KDDI自身が展開する「au Style」や「auショップ」も含まれる。
■産業用ロボットと接客用ロボットの違い、そして今後の展望
2026年に業界で広く取り上げられているヒューマノイドの導入例は、Figure AIによる工場での活用、HyundaiにおけるBoston Dynamicsの「Atlas」、ToyotaにおけるAgility Roboticsの「Digit」など、産業用ロボットに関するものだ。これらが使われるのは、処理量が多く、同じ作業を繰り返す環境である。そこではロボットの会話能力は重要ではなく、物理的な動作の精度が決定的な意味を持つ。
一方、KDDIとAVITAのシステムは、アーキテクチャの面で異なる方向を目指している。物体を操作する能力ではなく、会話と非言語的な存在感を主な価値とするヒューマノイドを展開しようとしているのだ。Gemini 3.1 Flash Liveの音声アーキテクチャが十分な性能に達し、AVITAの声以外の表現も含むハードウェアが十分な信頼性を備えたことで、顧客が台本どおりに動くシステムとやり取りしているとは感じない水準を超えられるかどうかが、この取り組みの賭けとなる。
この水準に達したという主張は過去にもなされており、最も有名で、結果的に成功しなかった例がPepperだった。KDDIとAVITAが2026年秋に予定している実証実験によって、その壁を越えたことが確認されるのか。それとも、従来と同じ隔たりが別の形で明らかになるのか。今回の展開は、その問いに答えるための試みである。
■注目ポイントQ&A
●Gemini 3.1 Flash Liveとは何ですか。また、なぜ接客ロボットにとって重要なのですか。
Gemini 3.1 Flash Live Previewは、2026年3月下旬に提供が開始されたGoogleのリアルタイム音声モデルです。音声をテキストに変換し、言語モデルで処理してから再び音声に合成する従来の音声AIは、3段階の処理に数秒を要し、その過程で声のトーンに関する情報が失われます。これに対してGemini 3.1 Flash Live Previewは、音声を文字起こしせず、エンドツーエンドで処理します。これにより、話者の声の高さ、話すペース、感情的な響きが処理全体を通じて保持され、モデルはそれらを踏まえて応答を生成できます。接客ロボットにとっては、ソフトバンクのPepperのような従来のシステムを不自然に感じさせていた、言葉は聞き取れても話し方を安定して認識できないという隔たりを埋められる可能性があります。
●ソフトバンクのPepperとは何が違うのですか。
Pepperは、音声認識、推論、音声合成という従来型の音声処理パイプラインで動作し、顧客が質問してからロボットが応答するまで数秒の遅延がありました。さらに重要なのは、文字起こしの段階で、声のトーン、話すペース、高さに含まれる感情的な情報など、パラ言語的な手がかりが失われていたことです。Pepperの商業展開で明らかになった問題には、感情を示す手がかりを安定して認識できず、台本に基づく対話に制約されたことが含まれます。KDDIとAVITAのシステムは、Gemini 3.1 Flash Liveのネイティブ音声処理を使い、音声信号を途中で文字起こしする処理を避けることで、対話全体を通じてこれらの手がかりを保持します。
●ロボットはどのような分野で、いつ導入される予定ですか。
KDDIとAVITAは、2026年秋に商業施設で実証実験を行う計画を発表しています。対象としているのは、小売、医療・福祉、エンターテインメント、文化・芸術施設の4分野です。将来の導入候補には、KDDIの携帯電話販売店である「au Style」や「auショップ」も含まれます。両社は、こうした環境への導入を通じて、日本の構造的な人手不足に対応しようとしています。日銀短観の雇用人員判断DIは過去30年間で最も深刻な人手不足を示す水準となり、帝国データバンクの2026年4月の調査でも、50.6%の企業が正社員不足を報告しています。
●現状のシステムにおける技術的な制限は何ですか。
Gemini 3.1 Flash Liveモデルは、2026年7月時点では「プレビュー」段階であり、まだ一般提供されていません。また、現時点では関数を順番に呼び出す方式だけをサポートし、複数の関数を並列に呼び出すことには対応していないため、複雑な複数段階のタスクでは制約となります。ヒューマノイドの空気圧アクチュエータには外部のエアコンプレッサーが必要で、管理された施設以外へ導入する場合には運用が複雑になります。さらに、KDDIは大阪堺データセンターでGeminiモデルをオンプレミス展開することも検討していますが、現在の実装はクラウド側の推論に依存しています。そのため、実環境での遅延は、各導入場所における5Gネットワークの状態に左右されます。
元記事: KDDI Robot Hears Your Tone, Not Just Words: Japan Tests Gemini Live Service Android
※この記事はTech Timesから提供を受けた記事を日本向けに翻訳・編集したものです。
スポンサードリンク

