OrcaRouter、27Bのエージェント向けAIモデルを4分の1以下に圧縮した「OrcaSAQ-2 27B」を公開
配信日時: 2026-09-25 13:00:00
54GBのモデルを12.3GBに。元モデルとの回答一致率は93.2%、SWE-bench Verifiedは70.0
FlashLabs株式会社(本社:東京都千代田区、代表取締役:細井洋一、以下「FlashLabs」)は、米国のAI研究機関Continuum AIが開発し、当社が日本市場向けに独占提供するAI推論ゲートウェイ「OrcaRouter」の研究チームが、Qwen3.8-27Bを高精度のまま圧縮した「OrcaSAQ-2 27B」を公開したことをお知らせします(2026年9月24日公開・Apache-2.0ライセンス)※1。
[画像: https://prcdn.freetls.fastly.net/release_image/138449/98/138449-98-a1c0653cc0df9c14e86442e552968c41-2400x1260.png?width=536&quality=85%2C75&format=jpeg&auto=webp&fit=bounds&bg-color=fff ]
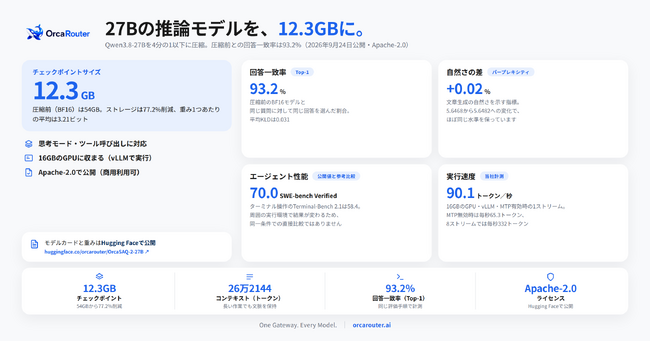
「OrcaSAQ-2 27B」は、270億規模のパラメータを持つモデルのファイルサイズを、54GBから12.3GBへ約4分の1以下に圧縮しながら、圧縮前のモデルと同じ判断を維持することを目指して開発されたモデルです※2。圧縮前のモデルと比べた回答の一致率(Top-1一致率)は93.2%、文章生成の自然さを示す指標(パープレキシティ)の差は0.02%。ほぼ同じ自然さを保ったまま、サイズを小さくすることに成功しています※2。コーディングエージェントの指標であるSWE-bench Verifiedでは70.0、ターミナル操作のTerminal-Bench 2.1では58.4を記録しました※2。
長時間動き続けるAIエージェントは、小さな判断の誤りが次の判断に影響し、作業の最後まで積み重なるという特性があります。モデルを小さくすれば動かせる環境は広がりますが、判断が変わってしまえばエージェントは仕事を完了できません。本研究は、サイズと引き換えに何が残るのかを測定することを軸にしています※2。
主なポイント
- 27B(270億パラメータ規模)のモデルを54GBから12.3GBに圧縮。ストレージは77.2%削減※2
- 圧縮前のモデルとの回答一致率は93.2%。パープレキシティの差は+0.02%(5.6468→5.6482)、平均KLDは0.031※2
- SWE-bench Verified 70.0/Terminal-Bench 2.1 58.4(公開値の参考比較・当社計測)※2
- コンテキスト長は26万2144トークン。思考モード・ツール呼び出し・MTP(投機的デコーディング)に対応※2
- 16GBのGPUで実行でき、1ストリームあたり毎秒90.1トークン(vLLM・MTP有効時・当社計測)※2
- ライセンスはApache-2.0。Hugging Faceで重みを公開※1
開発の背景
27Bクラスのモデルは、コーディングやツール操作など実務に近い作業をこなせます。しかし元の形式(BF16)では54GBのメモリが必要で、手元のGPUや1台のサーバーで動かすには大きすぎるという課題がありました※2。
サイズを小さくする方法は以前からありますが、圧縮すると判断がわずかに変わり、その誤差が長時間の作業で蓄積するという問題があります。エージェントは「計画する→実行する→結果を見る→判断する→立て直す」という流れを繰り返すため、途中の判断が変わると、その後のすべての判断が変わります※2。短いテストでは見えない劣化が、長い作業では表面化しやすいのです※2。
「OrcaSAQ-2 27B」は、この「長期の作業で使えるか」という観点を圧縮の評価軸に置いています※2。
圧縮方式
「OrcaSAQ-2 27B」は、モデルの各部分が圧縮による影響を受けやすいかどうかを見極め、精度の配分を変える独自の混合精度圧縮方式(OrcaSAQ2)によるモデルです※2。重み1つあたりの平均は3.21ビットで、全体を均一に圧縮するのではなく、影響の大きい部分に情報量を多く配分しています※2。
配布されているのは、vLLM(推論サーバー)から実行するための重み一式です。実行には「OrcaSAQ2」に対応したvLLM連携が必要です※2。詳細な圧縮手法・調整方法・精度配分・パッキング方式は現時点で非公開です※2。
圧縮前のモデルとの一致度
すべての数値は、同じ評価手順で圧縮前のモデル(BF16)と比較して計測しています※2。
- チェックポイント:54GB → 12.3GB(22.8%)
- パープレキシティ:5.6468 → 5.6482(差は0.02%)
- 回答一致率(Top-1):100% → 93.2%
- 平均KLD:0.031
- コンテキスト長:26万2144トークン(変更なし)
長時間稼働での性能
エージェントのベンチマークは、周囲の仕組み(ツール、推論の余裕、制限時間、実行環境)によって結果が変わります。以下は公開されている値との参考比較であり、同一条件での直接比較ではありません※2。
SWE-bench Verified
- Claude Sonnet 4.6:79.6
- Claude Sonnet 4.5:77.2
- Gemini 3:76.2
- OrcaSAQ-2 27B:70.0
- Qwen3-Coder-480B-A35B:69.6
- Gemini 2.5 Pro:63.8
- GPT-4.1:54.6
Terminal-Bench 2.1
- Gemini 3.1 Pro/Terminus 2:70.7
- Claude Opus 4.6/Claude Code:70.1
- Claude Opus 4.6/Terminus 2:63.8
- Claude Sonnet 4.6/Claude Code:58.5
- OrcaSAQ-2 27B:58.4
- Gemini 3 Flash/Gemini CLI:56.9
- GPT-5.4/Terminus 2:54.8
当社が検証した同規模のモデルの中では、実行できるサイズに対するエージェント能力の密度が高い水準にあると評価しています※2。
実行環境
- 重み:12.3GB(16GBのGPUに収まるサイズ)※2
- 実行:vLLM+「OrcaSAQ2」連携※2
- 速度:1ストリームで毎秒90.1トークン(15.7GiBのメモリ上限で計測・MTP有効時)。MTPを無効にすると1ストリームは毎秒65.3トークン、8ストリームでは毎秒332トークン※2
- 16GBのGPUで動かす場合の実用的な開始点は、対話用途で約3万2000トークンのコンテキスト。モデルの仕様上の上限は26万2144トークン※2
提供形式
- Hugging Face:https://huggingface.co/orcarouter/OrcaSAQ-2-27B
- ライセンス:Apache-2.0(圧縮前のQwen3.8-27Bから引き継がれます。圧縮によって元のライセンス条件が変わることはありません)※2
- 対応:テキストのみ(画像入力には対応しません)※2
今後の展望
FlashLabsは、AIエージェントの導入を検討する日本の企業や開発者に対して、高性能なモデルを現実的な設備で運用するための選択肢を紹介してまいります。あわせてOrcaRouterでは、用途に応じてモデルを選び分けられる環境と、実行記録の確認・ガードレールなどの運用機能を提供しています。
OrcaRouterについて
OrcaRouterは、米国のAI研究機関Continuum AIが開発し、FlashLabs株式会社が日本市場向けに独占提供するAI推論ゲートウェイ(AIモデルへのアクセスを1つにまとめる中継サービス)です。OpenAI互換のAPIを備え、Anthropic、OpenAI、Google Gemini、DeepSeek、Grok、Qwenなど200以上のLLM・生成AIモデルを単一のゲートウェイから利用できます。OrcaRouterのAIモデル一覧からすべてのモデルを確認できます。
会社概要
FlashLabs株式会社
- 本社所在地:東京都千代田区一番町10番8号
- 代表取締役:細井洋一
- 設立:2023年7月
- 事業内容:AI応用研究所(Human-AI Hybridで営業・CXの自動化・自律化。OSS音声モデルChromaの開発元)
- URL:https://www.flashlabs.ai/
Continuum AI
- 「次の10年の知能システムを支える基盤インフラを開発する研究機関(米国)」
- OrcaRouterの開発・提供
- URL:https://www.continuum01.ai/
本件に関するお問い合わせ
FlashLabs株式会社 マーケティング部 小林光喜
E-mail:koki.kobayashi@myflashcloud.com
※1 「OrcaSAQ-2 27B」の公開・提供形式・ライセンスに関する記述は、Hugging Faceのモデルページ「orcarouter/OrcaSAQ-2-27B」(2026年9月24日公開)およびOrcaRouter公式Xアカウント(@OrcaRouter)での発表(2026年9月24日)に基づきます。
※2 数値・仕様・実行環境に関する記述は、同モデルページの記載(2026年9月24日時点)に基づきます。圧縮前モデルとの比較値は、同じ評価手順で計測されたものです。ベンチマークは周囲の実行環境によって結果が変わるため、公開値との比較は参考情報であり、同一条件での直接比較ではありません。圧縮は数学的に無損失ではなく、一致率93.2%は一部の判断が圧縮前と異なることを意味します。また、パープレキシティの差はモデルの再現性を示す指標であり、下流タスクの性能が同一であることを保証するものではありません。画像入力には対応せず、仕様上の最大コンテキストがすべてのGPUメモリ構成に収まることを意味するものでもありません。
※3 本リリースに掲載しているURLは、2026年9月25日時点で当社が確認したものです。
PR TIMESプレスリリース詳細へ
スポンサードリンク
「FlashLabs株式会社」のプレスリリース
スポンサードリンク
最新のプレスリリース
- 田原町・蔵前に貸し会議室・レンタルスペース3会場を9月18日オープン 最大40名対応の「TIME SHARING 田原町 USUI ANNEX」09/25 19:15
- 合同会社AMAMO、タンザニア政府・BrickLayers Asset ManagementとJCMプロジェクト推進に向けたMOUを締結09/25 19:15
- 植田圭輔プロデュースの“フットサル×エンターテインメントショー”『ACTORS☆LEAGUE in Futsal 2026』「ABEMA PPV」にて10月13日(火)18時より独占生放送決定!09/25 19:15
- 北九州の魅力を再発見する「Rethink Creator PROJECT」北九州セミナーポスター作品の贈呈式を執り行います!09/25 19:15
- 【佐賀バルーナーズ】2026-27シーズン オフィシャルパフォーマンスチーム「BAL-VENUS」オープニングダンス振付師にyurinasia氏の就任が決定!09/25 19:15
- 最新のプレスリリースをもっと見る

