OrcaRouter、1.5TB超の大規模LLM「GLM-5.3」を1台のMacで実行できる「GLM-5.3-MLX」を公開
配信日時: 2026-08-31 14:30:02
約743BパラメータのオープンウェイトAIモデルを約79%小型化。512GBメモリ搭載Macでのローカル実行を実現
FlashLabs株式会社(本社:東京都千代田区、代表取締役:細井洋一、以下「FlashLabs」)は、米国のAI研究機関Continuum AIが開発し、当社が日本市場向けに独占提供するAI推論ゲートウェイ「OrcaRouter」において、Z.ai社のオープンウェイトLLM「GLM-5.3」(総パラメータ約743B・アクティブ40B・1Mトークンコンテキスト)をApple Silicon向けに最適化したMLX量子化版「GLM-5.3-MLX」を公開したことをお知らせします。本モデルはHugging Face上で公開されています。
[画像: https://prcdn.freetls.fastly.net/release_image/138449/71/138449-71-c2bd7fdb55c679c46540c54e84f5278d-2400x1260.jpg?width=536&quality=85%2C75&format=jpeg&auto=webp&fit=bounds&bg-color=fff ]
主なポイント
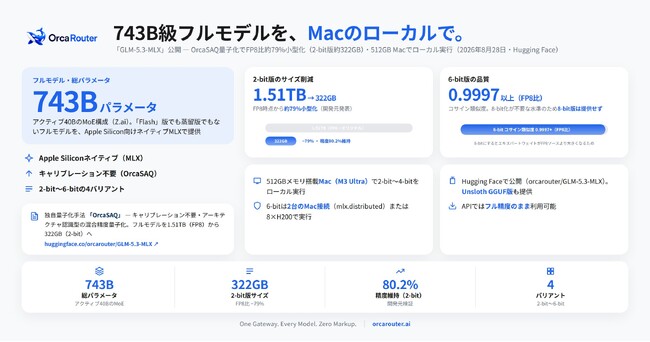
- 「Flash版」「蒸留版」ではない、フルモデル「GLM-5.3」(総パラメータ約743B・アクティブ40B)をApple Silicon向けに最適化
- 開発元独自の量子化手法「OrcaSAQ」により、FP8時点の約1.51TBから2-bit版で約322GBへ、約79%小型化
- 2-bit版で約**80.2%**の精度を維持(開発元検証)
- 2-bit~6-bitの4バリアントを提供。512GBメモリ搭載Mac(M3 Ultra)では2-bit~4-bitをローカル実行可能
- 6-bit版はFP8に対しコサイン類似度0.9997以上。6-bit実行は2台の512GB Macを接続する分散構成(mlx.distributed)または8×H200で対応
- Hugging Face上で公開。GGUF版はUnslothからも提供。APIではフル精度のまま利用可能
開発の背景
大規模言語モデル(LLM)のローカル実行は、データを外部に送信せずに済むこと、レイテンシーが低いことなどから、開発者や企業の関心が高まっています。一方で、最先端のオープンウェイトモデルは動作に数百GB規模のメモリを必要とすることが一般的で、多くの開発者が日常的に使うデバイスでの実行は困難でした。
この課題に対してOrcaRouterは、モデルを圧縮しながら性能を保つ量子化技術の開発を進めており、その成果のひとつが独自量子化手法「OrcaSAQ」(Orca Sensitivity-Aware Quantization)です。キャリブレーション用データを必要とせず、モデルの構造に応じて精度保持に重要なテンソルを高精度に保つ混合精度量子化方式で、性能とメモリ使用量のバランスを高水準で両立します。2026年8月28日には、同手法により「GLM-5.3-Flash」(総パラメータ320B)のApple Silicon向けMLX版を公開しており、今回の「GLM-5.3-MLX」はフルモデルへの展開となります。
GLM-5.3-MLXについて
「GLM-5.3」は、Z.ai社のフラッグシップとなるオープンウェイトLLMです。総パラメータ約743B・アクティブ40BのMoE(Mixture of Experts)構成で、1Mトークン(100万トークン)のコンテキストに対応します。「GLM-5.3-MLX」は、このフルモデルをApple Silicon向けに最適化したネイティブMLX版で、OrcaSAQにより「2-bit」「3-bit」「4-bit」「6-bit」の4バリアントを提供します。もっとも圧縮率の高い2-bit版では、FP8時点の約1.51TBから約322GB(約79%削減)まで小型化しつつ、約80.2%の精度を維持するという検証結果が得られています。
実行環境については、512GBメモリを搭載するMac(M3 Ultra)では、2-bit・3-bitは快適に、4-bitはフィットする構成でローカル実行できます。最上位の6-bit版は、2台の512GB Macをmlx.distributedで接続する分散実行、または8基のNVIDIA H200で実行する構成を想定しています。なお、8-bit版は提供していません。6-bit版がFP8に対しコサイン類似度0.9997以上を達成しており、8-bit化するとエキスパートウェイトがFP8のソースウェイトより大きくなるためです。
本モデルはHugging Face(orcarouter/GLM-5.3-MLX)で公開されており、量子化の強度を用途と実行環境に応じて選択できます。また、UnslothによるGGUF版も提供されており、llama.cppなどGGUF対応の実行環境でも利用できます。ローカル実行が難しい環境では、OrcaRouterのAPIからGLM-5.3のモデルページ経由でフル精度のまま利用可能です。
今後の展望
OrcaRouterは今後も、大規模モデルを身近なデバイスで活用できるようにする量子化技術の研究開発と、モデルカタログの拡充を進めてまいります。
OrcaRouterについて
OrcaRouterは、米国のAI研究機関Continuum AIが開発し、FlashLabs株式会社が日本市場向けに独占提供するAI推論ゲートウェイです。OpenAI互換のAPIを備え、Anthropic、OpenAI、Google Gemini、DeepSeek、Grok、Qwenなど200以上のLLM・生成AIモデルを単一のゲートウェイから利用できます。直近では、GPT-5.6、Claude Opus 5、Gemini 3.6 Flash、Grok 4.6、Muse Spark 1.2など、各社の最新モデルが公開後まもなくカタログに追加されています。OrcaRouterのAIモデル一覧からすべてのモデルを確認できます。
会社概要
FlashLabs株式会社
- 本社所在地:東京都千代田区一番町10番8号
- 代表取締役:細井洋一
- 設立:2023年7月
- 事業内容:AI応用研究所(Human-AI Hybridで営業・CXの自動化・自律化。OSS音声モデルChromaの開発元)
- URL:https://www.flashlabs.ai/
Continuum AI
- 「次の10年の知能システムを支える基盤インフラを開発する研究機関(米国)」
- OrcaRouterの開発・提供
- URL:https://www.continuum01.ai/
本件に関するお問い合わせ
FlashLabs株式会社 マーケティング部 小林光喜
E-mail:koki.kobayashi@myflashcloud.com
※1 GLM-5.3の仕様(総パラメータ数・アクティブパラメータ数・コンテキスト長等)はZ.ai社の公式発表に基づきます。
※2 モデルサイズ・圧縮率・精度・実行環境等の数値は、OrcaRouter公式発表(2026年8月28日)およびHugging Face上のモデルリポジトリ(2026年8月30日時点・当社確認)に基づきます。
※3 6-bit版の検証結果(FP8比コサイン類似度0.9997以上)は開発元の公式発表に基づきます。
PR TIMESプレスリリース詳細へ
スポンサードリンク
「FlashLabs株式会社」のプレスリリース
- OrcaRouter、セキュリティ研究向けモデル「GLM-5.3-Flash-Uncensored」を公開08/31 17:46
- OrcaRouter、Alibaba発LLM「Qwen3.8-Flash-Next」をベースにしたセキュリティ研究向けモデル「Qwen3.8-Flash-Next-Uncensored」を公開08/29 10:45
- OrcaRouter、AIコードレビュー機能「OrcaCode Review」の提供を開始 - シート課金ではなくトークン課金、200以上のモデルからレビューに使うモデルを自由に選択08/28 17:45
- 「FlashLabs株式会社」のプレスリリースをもっと読む
スポンサードリンク
最新のプレスリリース
- バンもん!が夏に浮かされた「激アツ爆ネツどんどこ音頭」の前衛的なMVが公開08/31 20:00
- 【最大50%OFF】フレージュ、大好評につき楽天スーパーSALEに参加! 口コミで話題の商品も特別価格に<9/4〜>08/31 19:50
- AI検索対策エージェント「Brand UP」提供開始 | 1ヶ月でAI言及率が3.8%→52.8%と13.9倍へ08/31 19:45
- 【今年は、“一緒に飲もう”を持って帰る。】IBC2025銅賞PROUSTで敬老の日の乾杯08/31 19:30
- 【福岡県庁】「花と温泉」をテーマに、原鶴温泉・朝倉市で『原鶴湯ったりよかぜ祭り』を開催します!08/31 19:15
- 最新のプレスリリースをもっと見る

